Last updated on April 10, 2026 6:12 PM
一键回城。
决策树
回忆:我们之前的很多模型都可以写成 y=wTx+b,决策逻辑(二分类):f(x)≥0 时预测为 1,否则预测为 0。
事实上这个逻辑可以写成一个树。
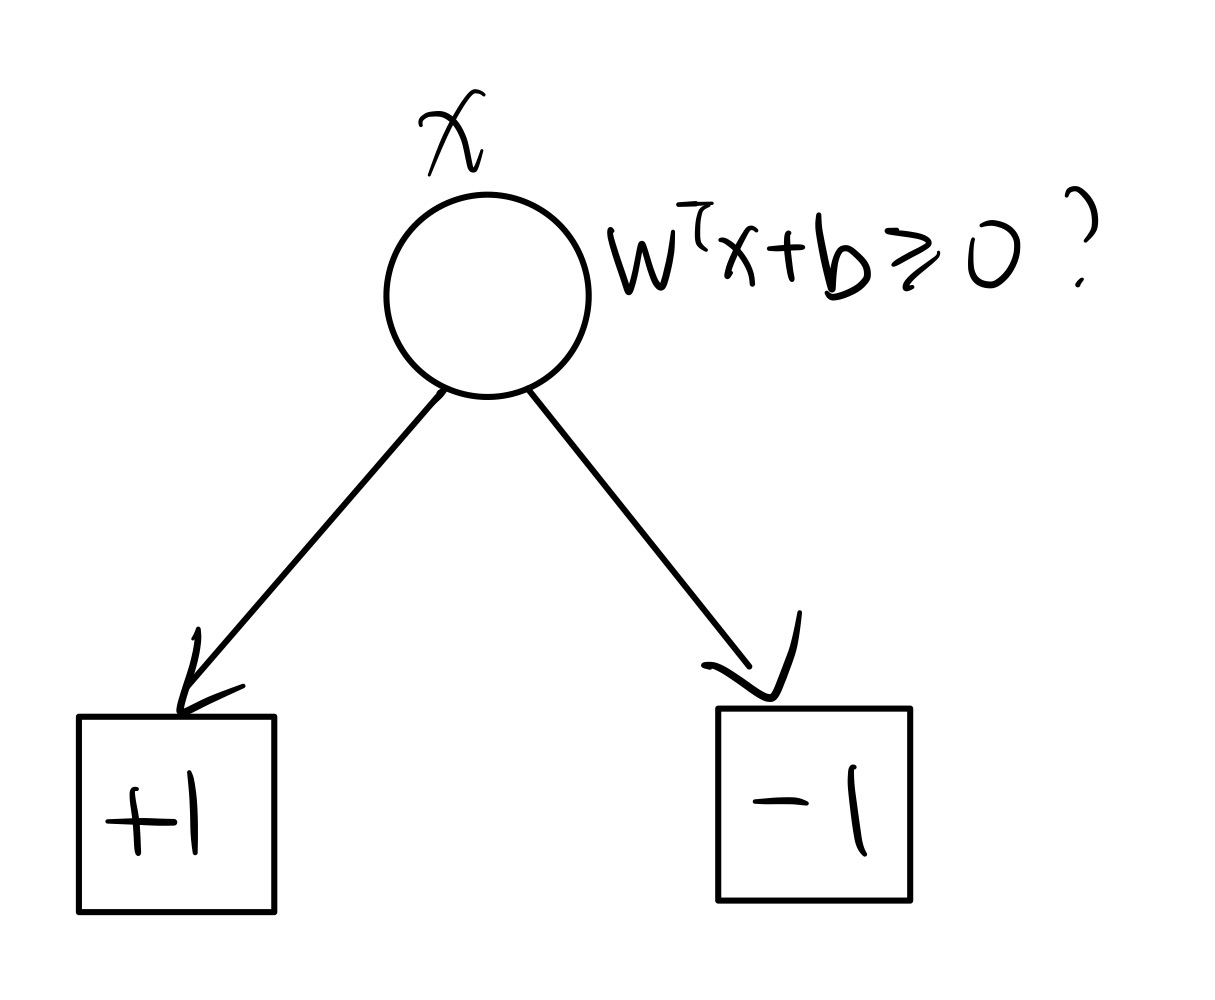
我们之前学习的模型多为线性模型,为了应对非线性性,我们可以考虑引入决策树。
决策树定义:一棵包含根节点、内部节点、叶子节点和有向边的树,每个非叶节点会将数据根据某种特性进行划分,一个数据点的预测值即为其对应的叶子节点对应的标签。
An example:
y∈{−1,+1},+1 表示其为一个好的研究者,−1 表示其为一个不好的研究者。
收集的数据如下:
| ID |
A |
B |
C |
y |
| 1 |
√ |
√ |
√ |
+1 |
| 2 |
√ |
√ |
× |
+1 |
| 3 |
√ |
× |
√ |
−1 |
| 4 |
× |
× |
× |
−1 |
| 5 |
× |
√ |
× |
−1 |
| 6 |
× |
× |
√ |
−1 |
| 7 |
× |
√ |
× |
−1 |
| 8 |
√ |
× |
√ |
−1 |
| 9 |
× |
√ |
× |
−1 |
A 表示是否勤奋,B 表示是否有好的视野,C 表示是否喜欢吃香蕉(?)
一个可能的决策树如下:
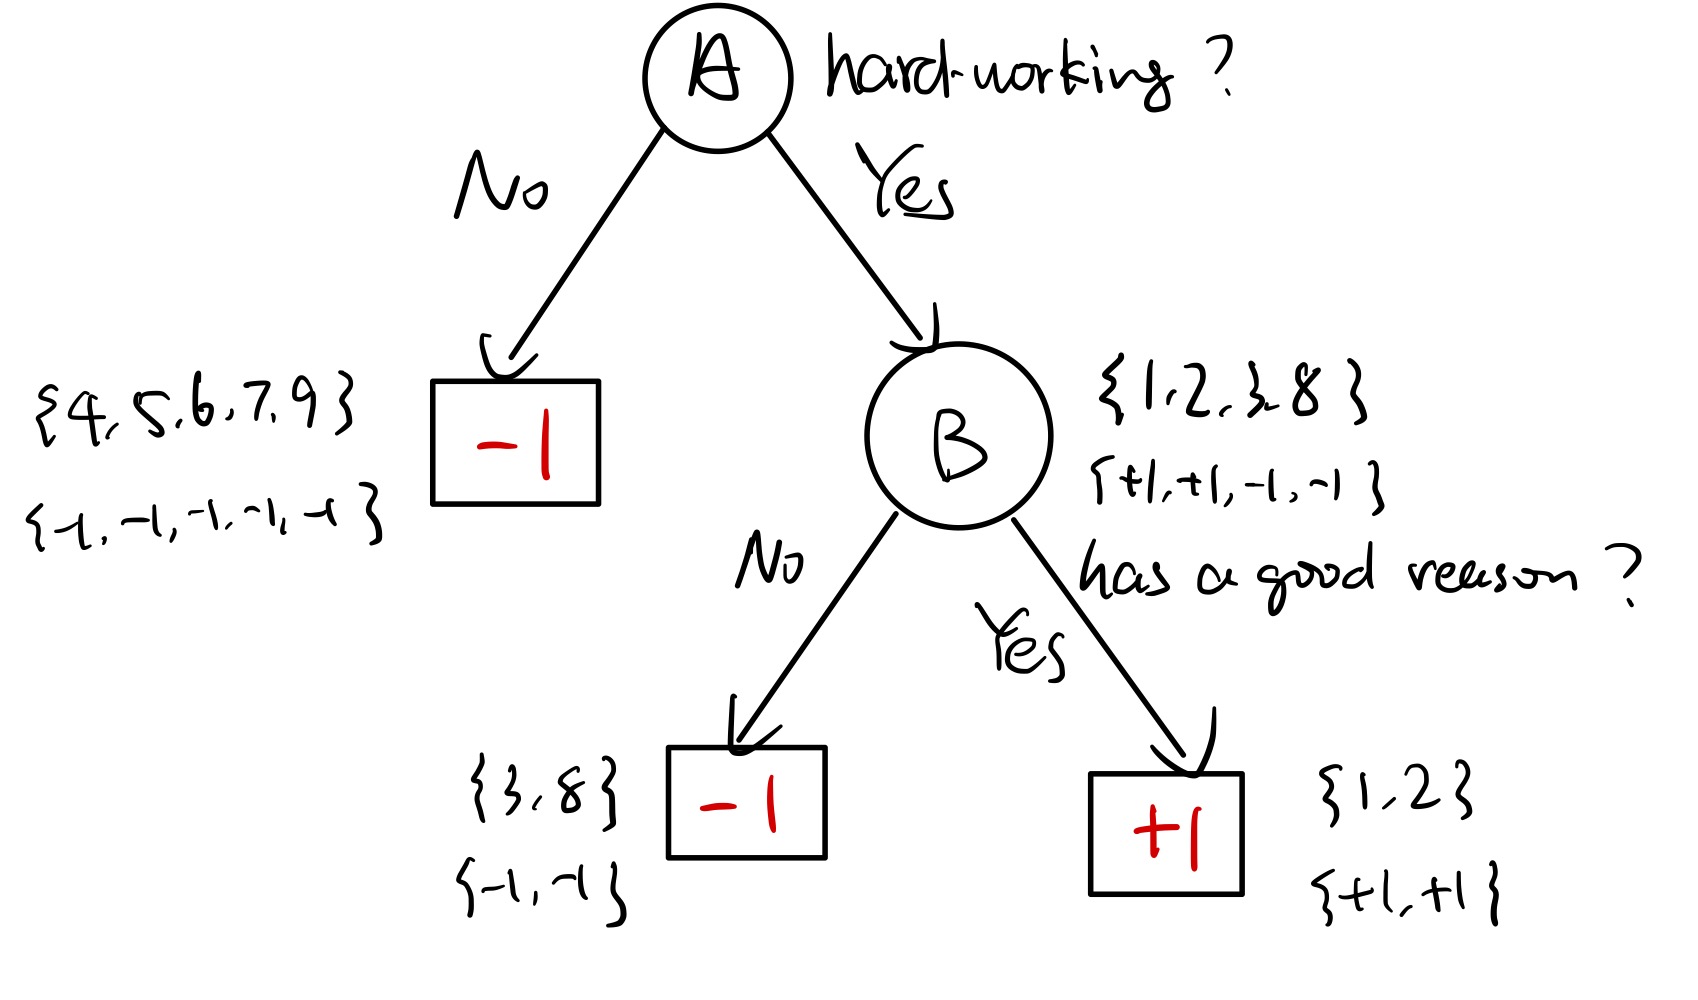
如果给定了一个十号数据点,{√,√,×},用该决策树对其进行预测,则可得到结果为 +1。
但是如果用 C 特征呢?会发现划分出来的东西不是很纯
熵
如何进行数据的划分?一个好的划分准则应当尽可能纯地进行划分数据。但是现实中如上面一般简洁的例子是不太可能存在的,所以我们需要定量地进行研究。
“纯度“的反义词就是“混乱程度”,自然想到用熵去进行度量。
对于离散随机变量 X,其熵被定义为
H(X)=x∑p(x)logp(x)1=−x∑p(x)logp(x)
此处 log 以 2 为底数,熵的单位为 bits。考虑扔 3 次硬币,硬币均匀,X 表示结果。H(X)=3,对应我们需要用 3 个 bits 来描述结果。但如果第三个硬币永远是正面,此时 H(X)=2,也就不需要第三个 bit 来编码第三个硬币了。
对于一个事件 X=x,p(x) 越低,其“包含的信息量”越高,我们就用的是 logp(x)1 表示所谓的“信息量”。例如,x=“太阳在东方升起”,p(x)=1,“包含的信息量极低”。又例如,x=“掷一个均匀骰子 3 次,得到三个 6”,p(x)=(61)3,logp(x)1≈7.75≫0,说明其“信息量”高,这是合理的。
而这个 H(X) 衡量的就是所有事件的平均“信息量”,所以对 logp(x)1 求期望也是不难理解的了。即衡量系统的不确定性,或者说混乱程度。
性质:
- 下界:H(X)≥0 恒成立。显然。当 ∃x 使得 p(x)=1 时,等号成立。
- 上界:H(X)≤log(x∑p(x)p(x)1)=logn,该上界由琴生不等式得到,考虑 log 的凹性(concavity)。等号当且仅当 ∀x,p(x)=n1,这也是很符合直觉的。
条件熵与互信息
对于两个随机变量 X,Y,可以定义其互信息(mutual information)
I(X;Y)=H(Y)−H(Y∣X)
H(Y∣X) 为条件熵(conditional entropy),意为观测到 X 后 Y 的不确定度。这里假设 x 有 m 种可能取值。
H(Y∣X)=i∈[m]∑P(X=xi)H(Y∣X=xi)
而 I(X;Y) 衡量的就是某种观察到 X 后,Y 的不确定度的减少程度,也可以理解为 X 中与 Y 有关的信息量。
X 与 Y 越相关,I(X;Y) 越大。其关系可以大致用如下的图表示:
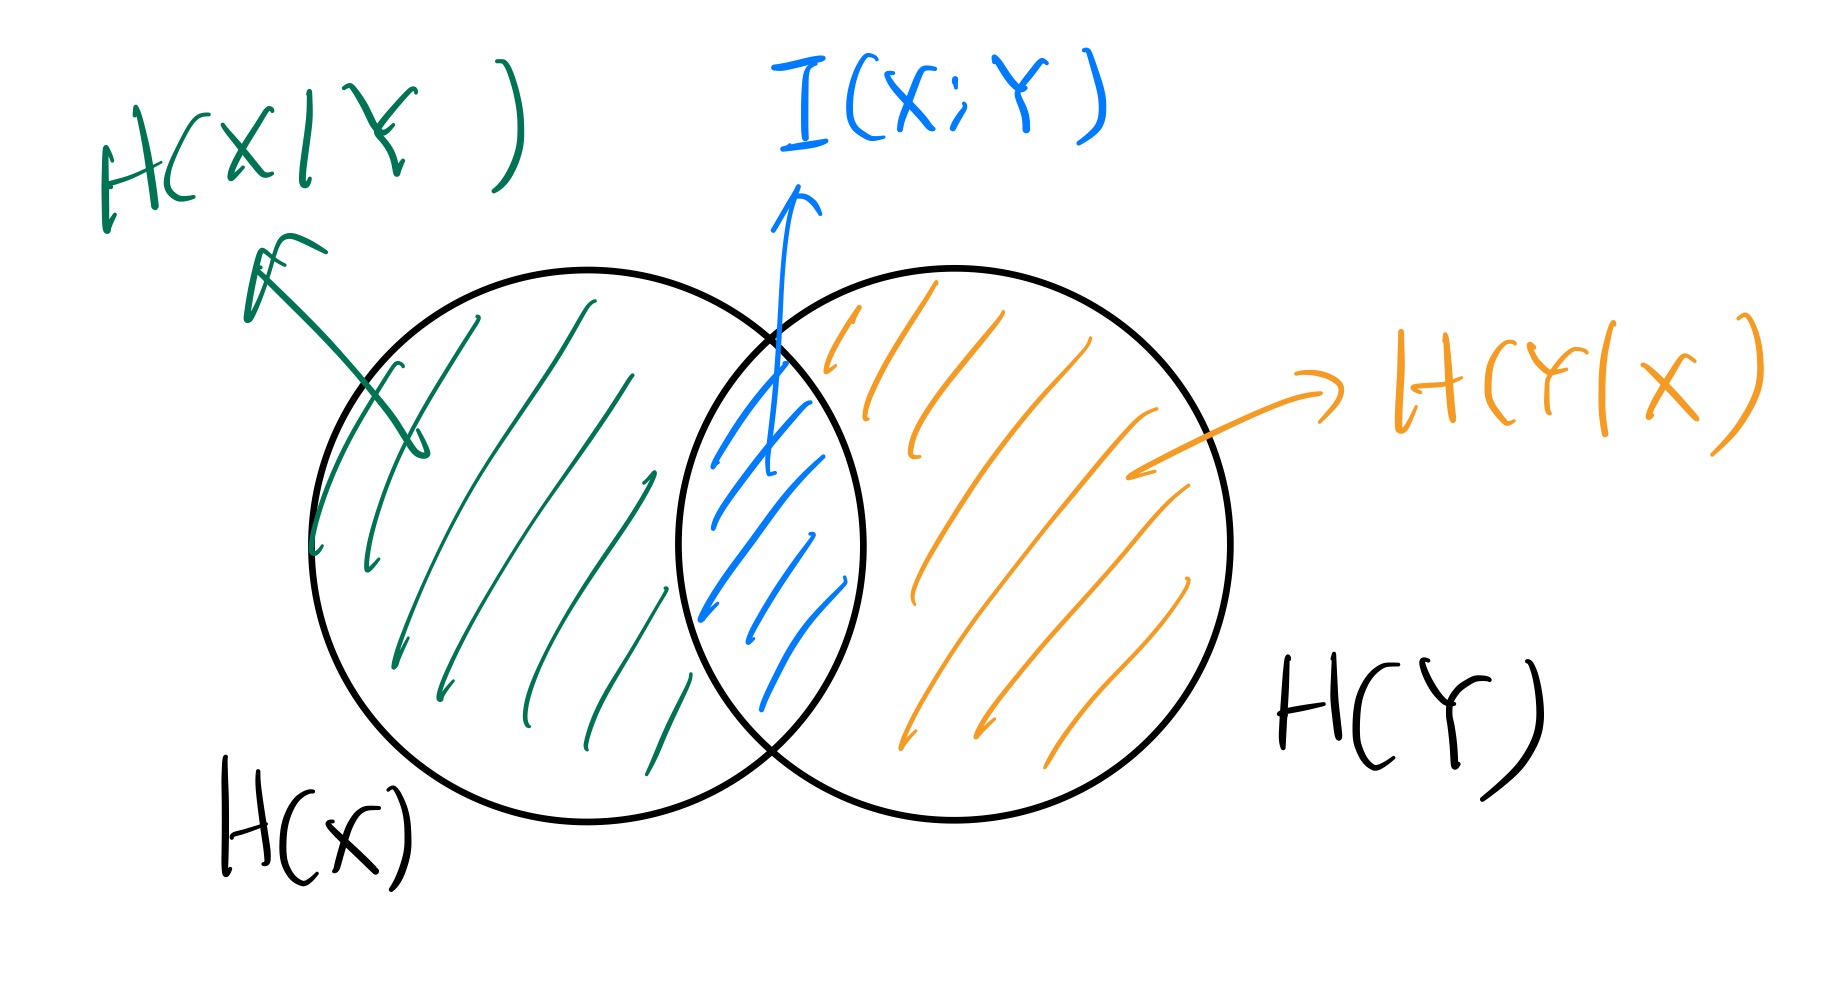
事实上可以发现,I(X;Y) 具有对称性,即 I(X;Y)=H(Y)−H(Y∣X)=H(X)−H(X∣Y)。且 I(X;Y)=H(X)+H(Y)−H(X,Y)。
以及,当 X,Y 独立时,I(X;Y)=0,这是很符合直觉的。
信息增益(information gain)被定义为
g(D,A)=H(D)−H(D∣A)
记号约定:D 为训练集,A 为某种属性(假设其为离散的,A∈{a1,⋯,am},有 m 种离散取值),且假设问题为多分类问题,即 y∈[K]。
H(D) 表示还未划分前,训练集中标签的纯度,定义为
H(D)=−k∈[K]∑∣D∣∣Ck∣log∣D∣∣Ck∣
其中 Ck 表示 D 中标签为 k 的数据构成的子集,∣D∣∣Ck∣ 事实上就是在衡量 P(y=k)。
H(D∣A) 定义为
H(D∣A)=i∈[m]∑∣D∣∣Di∣⋅H(D∣A=ai)=−i∈[m]∑∣D∣∣Di∣k∈[K]∑∣Di∣∣Di∩Ck∣log∣Di∣∣Di∩Ck∣
Di 表示 D 中满足 A=ai 的数据构成的子集,∣Di∣∣Di∩Ck∣ 就是在度量 P(y=k∣A=ai)。
g(D,A) 就表示的是,用 A 划分 D 后,能使得混乱程度减少多少,即 A∗=Aargmaxg(D,A)。
结合前面的条件熵相关知识,我们发现 g(D,A) 的本质就是 H(y)−H(y∣A)=I(y;A),要选择一个与 y 的互信息最大的 A,这也是很符合直觉的。
例:假设有特征 A,B,A 有两个离散等概率取值 a1,a2,B 有十个离散等概率取值 b1,⋯,b10,分类标签 y∈[10] 且在数据集 D 内均匀分布。假设 y 在每个 bi 下是“纯的”,且 A=a1⟹y≤5,A=a2⟹y≥6(也各自是等概率的,即 P(y=i∣A=a1)=51,∀i∈[5],a2 的情况同理),计算 g(D,A) 与 g(D,B)。
首先,P(A=ai)=21,P(B=bi)=101。
H(D∣A=a1)=−i∈[5]∑51log51=log5H(D∣A=a2)=log5
所以,H(D∣A)=21log5+21log5=log5
接下来,由于 y 在每个 bi 中是纯的,所以 H(D∣B=bi)=0,自然 H(D∣B)=0。
而 H(D)=log10(由等概率性)。所以 g(D,A)=H(D)−H(D∣A)=log2=1,g(D,B)=H(D)−H(D∣B)=log10。
自然,根据信息增益越大越好的准则,log10>1,我们应该选择 B 来进行划分。
不过,这样的 B 未必就是最好的。考虑以数据的 ID 为特征,一样能够做到在每个 bi 中都是纯的! 或者说,每个样本都有一个自己的 feature,但这样的 B 不具有泛化性,不能帮助我们做预测。这便是信息增益的一个巨大局限:更倾向于选择有很多 values 的 feature,但这样的 feature 未必是好的。
定义:
gR(D,A)=HA(D)g(D,A)
其中
HA(D)=−i∈[m]∑∣D∣∣Di∣log∣D∣∣Di∣
本质上就是 H(A),衡量的是 A 本身的混乱程度,gR(D,A) 相当于用 H(A) 来“normalize” g(D,A),可以“抵消” IG 对取值很多的 feature 的偏好性。
在刚才的例子中,继续计算 gR(D,A) 和 gR(D,B)。由于 A 和 B 都是均匀的,所以 HA(D)=log2,HB(D)=log10。于是
gR(D,A)gR(D,B)=HA(D)g(D,A)=log21=1=HB(D)g(D,B)=log10log10=1
在这个指标下,就不会更偏好于 B 了。
基尼系数(Gini Index)
定义:
Gini(D)=k∈[K]∑∣D∣∣Ck∣(1−∣D∣∣Ck∣)
可以理解为是在计算 k∈[K]∑P(y=k)(1−P(y=k)),对比熵的定义 k∈[K]∑P(y=k)logP(y=k)1。趋势是一样的,所以基尼系数也可以理解为是在描述体系的混乱程度,基尼系数越大,不确定性越大。
接下来定义
Gini(D,A)=i∈[m]∑∣D∣∣Di∣Gini(Di)
即,对于每个特征 ai,分别计算每个划分下的基尼系数然后求平均。描述的是经过 A 划分后的混乱程度。
其自然是越小越好的(注意和前面的 IG 和 IGR 不一样),即 A∗=AargminGini(D,A)。
树回归
刚才我们一直在做分类问题。考虑当特征标签是连续的情况,即此时若我们是在做回归问题,如何衡量混乱程度?直接使用 L2 损失函数。
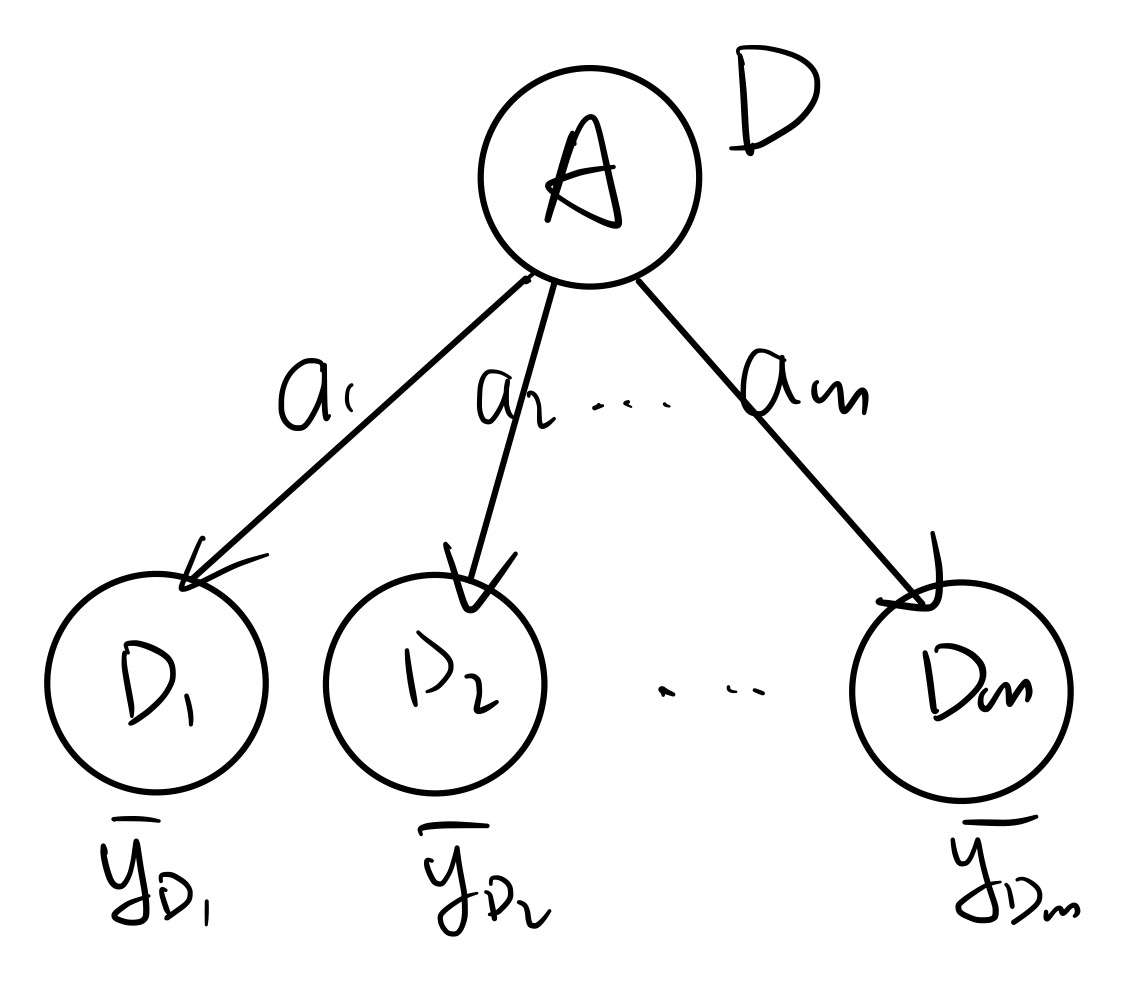
考虑上图的情况,特征 A 有 m 种取值,将 D 划分为 D1,⋯,Dm。每一类内包含若干 y 值。可以定义每一类内 y 的平均值:
yDi:=∣Di∣1j∈Di∑yi
则可定义出损失函数
L(D,A)=i∈[m]∑j∈Di∑(yi−yDi)2
选择特征时,即选择 A∗=AargminL(D,A)。
决策树的构建
如果硬要考虑每种可能的顺序的话,构建决策树是一个 NPC 问题。所以一般而言使用贪心算法去进行决策树的构建。
即递归地,从根节点开始,选择一个最好的特征 B,进行划分,然后在每个子节点内重复如上过程(不能再用 B 了)。