24秋机器学习笔记-04-支持向量机(SVM)

Last updated on April 10, 2026 6:12 PM

本文主要涉及支持向量机(Support Vector Machine)以及对偶理论。
一键回城。
本文所涉及部分用了 3 个课时来讲述,内容较多。

带约束的优化问题

先介绍一般性的优化问题,进而引出 K.K.T 条件。

等式约束下的优化问题

min⁡xf(x)\min_x f(x),s. t. h(x)=0h(x)=0,其中 f,hf,h 都可微。

  1. ∀x\forall x 在平面 h(x)=0h(x) = 0 上,有 ∇h(x)\nabla h(x) 与平面正交。
    如果有切向分量,说明我们沿着切向走可以使得 h(x)>0h(x)>0,与 h(x)=0h(x)=0 矛盾。
  2. 对于一个局部最小值 x∗x^*,梯度 ∇f(x∗)\nabla f(x^*) 也与平面垂直。
    若有切向分量,则沿着其反方向走,可以保证 h(x)=0h(x)=0 的约束不变,且 ff 可以继续降低。

一般而言,x∗x^* 为局部最小值的必要条件为:∃λ\exists \lambda 使得 ∇f(x∗)+λ∇h(x∗)=0\nabla f(x^*) + \lambda \nabla h(x^*) = 0,即这两个梯度共线;以及 h(x∗)=0h(x^*) = 0。

不考虑 corner cases(事实上在实际中也少见):我们需要 x∗x^* 为 regular point。

引入拉格朗日方程

L(x,λ)=f(x)+λh(x)L(x,\lambda) = f(x) + \lambda h(x)

其中 λ\lambda 为拉格朗日乘子。

如果有多个约束,则

L(x,[λ1,⋯ ,λn])=f(x)+∑i∈[n]λihi(x)L(x,[\lambda_1, \cdots ,\lambda_n]) = f(x) + \sum_{i \in [n]} \lambda_i h_i(x)

此时,x∗x^* 为局部最小值的必要条件可以写为:∃λ\exists \lambda 使得

{∇xL(x∗,λ)=0∇λL(x∗,λ)=0\begin{cases} \nabla_x L(x^*, \lambda) = 0 \\ \nabla_{\lambda} L(x^*, \lambda) = 0 \end{cases}

第一个式子等价于 ∇f(x∗)+λ∇h(x∗)=0\nabla f(x^*) + \lambda \nabla h(x^*) = 0,第二个等价于 h(x∗)=0h(x^*) = 0。

无限制优化的时候,我们其实只需要 ∇f(x∗)=0\nabla f(x^*) = 0,加上了约束之后,我们就利用拉格朗日乘子把约束放进方程里面。

同时,需要留意的是,如上为必要条件而非充分条件。

  • 从拉格朗日条件解出来的解可能不是局部最小解
  • 但是,所有的局部最小解肯定在我们解出来的 candidate set 里面。
  • 对于凸函数,局部最小解即为全局最小解。

带不等式约束的优化问题

问题描述:min⁡xf(x)\min_x f(x) s. t. g(x)≤0g(x)\le 0。

  1. 同样地,对于任意在 g(x)=0g(x)=0 平面上的 xx,也一定有 ∇g(x)\nabla g(x) 垂直于平面,并且指向平面外。
  2. 对于一个局部最优解 x∗x^*:
    • 若其在平面上,则 −∇f(x∗)-\nabla f(x^*) 的方向必须与 ∇g(x∗)\nabla g(x^*) 相同。

      该条件等价于 ∃μ>0\exists \mu > 0,s. t. ∇f(x∗)+μ∇g(x∗)=0\nabla f(x^*)+ \mu \nabla g(x^*)= 0。

    • 若在内部,已经满足约束 g(x)≤0g(x)\le 0,则只需要满足 ∇f(x∗)=0\nabla f(x^*) = 0 即可。

      该条件等价于 ∃μ=0\exists \mu = 0,s. t. λf(x∗)+μ∇g(x∗)=0\lambda f(x^*) + \mu \nabla g(x^*) = 0。(为了跟上面凑成一样的形式)

    • 所以,可以归结成:
      • g(x∗)≤0g(x^*) \le 0;
      • μ≥0\mu \ge 0;
      • μg(x∗)=0\mu g(x^*) = 0(若 g(x)g(x) 的约束 active,则 g(x)=0,μ>0g(x) = 0,\mu>0,若 inactive,则 g(x)<0,μ=0g(x)<0,\mu = 0)
      • ∇f(x∗)+μ∇g(x∗)=0\nabla f(x^*) + \mu \nabla g(x^*) = 0
    • 这四个条件称为 Karush-Kuhn-Tucker (KKT) 条件,为必要条件。

对其也可以定义拉格朗日方程:

L(x,μ)=f(x)+μg(x)L(x,\mu) = f(x) + \mu g(x)

KKT 条件说明,若 x∗x^* 为局部最小值,则:

  • ∇xL(x∗,μ)=∇f(x∗)+μ∇g(x∗)=0\nabla_x L(x^*, \mu) = \nabla f(x^*) + \mu \nabla g(x^*) = 0;
  • g(x∗)≤0g(x^*) \le 0;
  • μ≥0\mu \ge 0;
  • μg(x∗)=0\mu g(x^*) = 0。

等式/不等式约束都有的优化问题

问题描述:min⁡xf(x)\min_x f(x) s. t. hi(x)=0,∀i∈[k]h_i(x) = 0, \forall i \in [k],gj(x)≤0,∀j∈[l]g_j(x) \le 0, \forall j \in [l]

拉格朗日函数(其中 λ,μ\lambda,\mu 分别为 k,lk,l 维向量):

L(x,λ,μ)=f(x)+∑i∈[k]λihi(x)+∑j∈[l]μjgj(x)L(x, \lambda, \mu) = f(x) + \sum_{i \in [k]} \lambda_i h_i(x) + \sum_{j \in [l]} \mu_j g_j(x)

其 KKT 条件:若 x∗x^* 为局部最小值,则必要条件为:

  • ∇xL(x∗,λ,μ)=0\nabla_x L(x^*, \lambda, \mu) = 0(导数条件);
  • ∀i∈[k]\forall i \in [k] 有 hi(x∗)=0h_i(x^*) = 0 以及 ∀j∈[l]\forall j \in [l] 有 gj(x∗)≤0g_j(x^*) \le 0(可行性条件);
  • ∀j∈[l]\forall j \in [l] 有 μj≥0\mu_j \ge 0;
  • ∀j∈[l]\forall j \in [l] 有 μjgj(x∗)=0\mu_j g_j(x^*) = 0(互补松弛条件)。

还是有不等式条件,所以不一定能从 KKT 条件直接求出 candidate solutions。

SVM 原始形式推导

SVM 是一个线性分类器:f(x)=wTx+bf(x) = w^Tx + b,y∈{−1,1}y \in \{-1,1\}(同样只是 index)。

回忆:数据点线性可分的时候逻辑回归无穷多解的情况。

SVM 有一个明确的准则选择“最好的”分隔超平面:寻找一个使得间隔(margin)最大的超平面。margin 被定义为数据点到超平面的最小距离(max-min problem)。思想为结构风险最小化(Structural Risk Minimization)

Margin 越大,泛化性越强,也对离群值(outliers)更健壮(robust)。

而且一定在超平面两边都有至少一个(可以用调整法证明)能够支持这个超平面的点(称为 Support Vectors)

注意到,支持向量是直接决定分隔超平面的,但其他的点完全不会对支持向量的决策产生任何影响(对应表达式中的 inactive 约束)。

显然,xix_i 到超平面的距离为

di=∣wTx+b∣∥w∥d_i = \frac{|w^Tx+b|}{\left\| w \right\|}

推导?考虑垂足 x0x_0,则可以有

{x0+di⋅w∥w∥=xiwTx0+b=0\begin{cases} x_0+d_i\cdot \frac{w}{\left\| w \right\|} = x_i \\ w^Tx_0 + b = 0 \end{cases}

注意这里的 did_i 带有方向的含义,我们改用 γi\gamma_i 表示。上式左乘 wTw^T 即可配凑出 wTx0w^Tx_0,可以用 −b-b 换掉,于是即推出

γi=wTxi+b∥w∥\gamma_i = \frac{w^T x_i+b}{\left\| w \right\|}

取绝对值即得到 did_i 的式子。

也可以用拉格朗日乘子法。

相当于我们需要 min⁡x012∥xi−x0∥2\displaystyle \min_{x_0} \frac{1}{2} \left\| x_i - x_0 \right\|^2 s. t. wTx0+b=0w^Tx_0 + b = 0。

写出拉格朗日方程:

L(x0,λ)=12∥xi−x0∥2+λ(wTx+b)L(x_0,\lambda) = \frac{1}{2}\left\| x_i - x_0 \right\|^2 + \lambda (w^Tx+b)

求偏导有

{−(xi−x0)+λw=0wTx0+b=0\begin{cases} -(x_i - x_0) + \lambda w = 0\\ w^Tx_0 + b = 0 \end{cases}

类似地,上式左乘 wTw^T 可以解得 λ=wTxi+b∥w∥2\displaystyle \lambda = \frac{w^T x_i + b}{\left\| w \right\|^2}

回代,∥xi−x0∥=∣λ∣∥w∥=∣wTxi+b∣∥w∥\left\| x_i - x_0 \right\| = |\lambda| \left\| w \right\| = \displaystyle \frac{|w^T x_i + b|}{\left\| w \right\|},与前面得到的结果一致。

事实上我们会更多关注 γi\gamma_i,因其带有方向信息。γi>0\gamma_i>0 代表点 xix_i 在 wTx+b>0w^Tx+b>0 区域内,反之亦然。

定义

γiˉ=yiγi=yi(wTxi+b)∥w∥\bar{\gamma_i} = y_i \gamma_i = \frac{y_i(w^T x_i + b)}{\left\| w \right\|}

可以通过 γiˉ\bar{\gamma_i} 是否大于 00 判断一个点是否被正确分类(这里体现出一开始我们规定 yi∈{−1,1}y_i \in \{-1,1\} 的好处),就不需要分类讨论正负类的 γi\gamma_i 大于还是小于 00 了。

而之前讨论的所谓 margin 就是

γ=min⁡i∈[n]γiˉ\gamma = \min_{i \in [n]} \bar{\gamma_i}

于是,我们之前说过的优化问题就变为:max⁡w,bγ\displaystyle \max_{w,b} \gamma s. t. ∀i∈[n]\forall i \in [n] 有 γiˉ≥γ\bar{\gamma_i} \ge \gamma。

约束条件改写一下,变为:yi(wTxi+b)∥w∥≥γ\displaystyle \frac{y_i(w^Tx_i + b)}{\left\| w \right\|}\ge \gamma。

对于支持向量们,一定有 γiˉ=γ\bar{\gamma_i} = \gamma。假设 x0x_0 是某个支持向量,则 y0(wTx0+b)∥w∥=γ\displaystyle \frac{y_0(w^Tx_0 + b)}{\left\| w \right\|} = \gamma,用该式子替换掉 γ\gamma,优化问题变为 max⁡w,by0(wTx0+b)∥w∥\displaystyle \max_{w,b} \frac{y_0(w^Tx_0+b)}{\left\| w \right\|} s. t. yi(wTxi+b)≥y0(wTx0+b)\displaystyle y_i(w^T x_i+b)\ge y_0(w^Tx_0+b)。

称 y0(wTx0+b)y_0(w^Tx_0+b) 为 functional margin,w,bw,b 可以任意缩放使得其任意大或任意小(但这不影响 geometric margin)。

所以还不如直接令 y0(xTx0+b)=1y_0(x^Tx_0+b) = 1,某种程度上是种正则化。

所以优化的表达式变为 max⁡w,b=1∥w∥\displaystyle \max_{w,b} = \frac{1}{\left\| w \right\|} s. t. ∀i∈[n]\forall i \in [n] 有 yi(wTxi+b)≥1y_i(w^T x_i + b)\ge 1。等价于 min⁡w,b12∥w∥2\displaystyle \min_{w,b} \frac{1}{2} \left\| w \right\|^{2}(该形式更方便进行求导),该形式称为 SVM 的原始形式(The Primal Form of SVM)

该形式强制令 functional margin = 1,yi(wTxi+b)≥1y_i(w^T x_i+b)\ge 1 而不是 ≥0\ge 0 可以理解为要求所有的点到平面都有一个距离,以保证结构鲁棒性。

注意到这是一个二次规划(Quadratic Programming),有很多现成的标准包可以进行解决,具体的解决方法不在本节课的范围内。

剩余两个未能解决的问题:

  • 不线性可分
  • 线性可分但是有使得 margin 过于小的 outlier

SVM 对偶形式(Dual Form of SVM)

考虑拉格朗日函数(习惯上用 α\alpha 而不是之前的 μ\mu)

L(w,b,α)=12∥w∥2+∑i∈[n]αi(1−yi(wTxi+b))L(w,b,\alpha) = \frac{1}{2}\left\| w \right\|^{2}+\sum_{i \in [n]} \alpha_i(1 - y_i(w^T x_i + b))

定义

p∗=min⁡w,bmax⁡αi≥0L(w,b,α)p^* = \min_{w,b} \max_{\alpha_i \ge 0} L(w,b, \alpha)

Claim:p∗p^* 为 SVM 主形式的一个解。

相当于我们将带约束的 SVM 主形式变成了不带约束的双层优化问题。

证明:假设某些约束没有被满足,则 ∃i\exists i 使得 1−yi(wTxi+b)>01 - y_i(w^T x_i +b) > 0,则里层优化会让 αi→+∞\alpha_i \to +\infty 进而使得 max⁡αi≥0L(w,b,α)→+∞\displaystyle \max_{\alpha_i\ge 0}L(w,b,\alpha)\to +\infty,所以外层的优化一定会让所有约束得到满足进而避免这种趋于正无穷的情况。

而里层的优化会使得 αi=0\alpha_i = 0,所以最外层优化的就是我们需要的解。

这个形式可能不太好解,所以把他转换为对偶形式:

d∗=max⁡αi≥0min⁡w,bL(w,b,α)d^* = \max_{\alpha_i\ge 0}\min_{w,b} L(w,b,\alpha)

弱对偶定理:d∗≤p∗d^*\le p^*。

证明:注意到 min⁡w,bL(w,b,α)≤L(w,b,α),∀w,b\displaystyle \min_{w,b}L(w,b,\alpha)\le L(w,b,\alpha),\forall w,b,即 d∗≤max⁡ai≥0L(w,b,α),∀w,b\displaystyle d^*\le \max_{a_i\ge 0}L(w,b,\alpha),\forall w,b。所以 d∗≤min⁡w,bmax⁡αi≥0L(w,b,α)=p∗\displaystyle d^*\le \min_{w,b}\max_{\alpha_i\ge 0}L(w,b,\alpha) = p^*。

可以理解为两个人的博弈。最小的里面挑一个最大的一定小于等于在最大的里面挑一个最小的。

强对偶条件:d∗=p∗d^*=p^*,则 strong duality holds. not in general,但是在 SVM 这里是成立的。

斯拉特条件(Slater’s Condition):当目标函数为凸,且约束为线性,则强对偶条件满足。(证明略)

回忆:

p∗=min⁡w,bmax⁡αi≥0L(w,b,α)d∗=max⁡αi≥0min⁡w,bL(w,b,α)\begin{aligned} p^* &= \min_{w,b} \max_{\alpha_i \ge 0} L(w,b, \alpha) \\ d^* &= \max_{\alpha_i\ge 0}\min_{w,b}L(w,b,\alpha) \end{aligned}

证明弱对偶条件:假设 wp,bpw_p,b_p 为 p∗p^* 的解,αd\alpha_d 为 d∗d^* 的解。则

p∗=min⁡w,bmax⁡αi≥0L(w,b,α)=max⁡α≥0L(wp,bp,α)≥L(wp,bp,αd)≥min⁡w,bL(w,b,αd)=d∗\begin{aligned} p^* = \min_{w,b}\max_{\alpha_i \ge 0}L(w,b,\alpha) &= \max_{\alpha\ge 0} L(w_p,b_p, \alpha) \\ &\ge L(w_p,b_p,\alpha_d)\\ &\ge \min_{w,b}L(w,b,\alpha_d)\\ &= d^* \end{aligned}

而我们知道,若强对偶条件成立,则 p∗p^* 与 d∗d^* 的解是一样的,即 (wp,bp,αd)(w_p,b_p, \alpha_d),即上面式子中所有的不等号都是等号。这告诉我们,可以通过解对偶问题 d∗d^* 来解原问题。

max⁡α≥0min⁡w,bL(w,b,α)=12∥w2∥+∑i∈[n]αi−∑i∈[n]αiyi(wTxi+b)\max_{\alpha\ge 0}\min_{w,b}L(w,b,\alpha) = \frac{1}{2} \left\| w^{2} \right\| + \sum_{i \in [n]} \alpha_i - \sum_{i \in [n]} \alpha_i y_i(w^Tx_i +b)

先看里层的。由其凸性,进行求导,要求 ∂L∂w=0\displaystyle \frac{\partial L}{\partial w} = 0,∂L∂b=0\displaystyle \frac{\partial L}{\partial b} = 0

∂L∂w=w−∑αiyixi=0∂L∂b=−∑αiyi=0\begin{aligned} \frac{\partial L}{\partial w} &= w - \sum \alpha_i y_i x_i = 0 \\ \frac{\partial L}{\partial b} &= -\sum \alpha_i y_i = 0 \end{aligned}

这不就是 KKT 条件吗,原因就在于由于强对偶性,解是一样的,所以自然也需要满足 KKT 条件。

所以

w=∑i∈[n]αiyixi∑i∈[n]αiyi=0w = \sum_{i \in [n]} \alpha_i y_i x_i \\ \sum_{i \in [n]} \alpha_i y_i = 0

将其代入原来的式子,就有

max⁡α≥0min⁡w,bL(w,b,α)=12∥w2∥+∑i∈[n]αi−∑i∈[n]αiyi(wTxi+b)=max⁡α≥012(∑i∈[n]αiyixiT)(∑i∈[n]αiyixi)+∑i∈[n]ai    −∑i∈[n]αiyi(∑i∈[n]αiyixiT)Txi−b∑i∈[n]αiyi=max⁡α≥0∑i∈[n]αi−12∑i∈[n]∑j∈[n]αiαjyiyjxiTxj\begin{aligned} \max_{\alpha\ge 0}\min_{w,b}L(w,b,\alpha) &= \frac{1}{2} \left\| w^{2} \right\| + \sum_{i \in [n]} \alpha_i - \sum_{i \in [n]} \alpha_i y_i(w^Tx_i +b)\\ &=\max_{\alpha\ge 0} \frac{1}{2} \left( \sum_{i \in [n]} \alpha_i y_i x_i^T \right) \left( \sum_{i \in [n]} \alpha_i y_i x_i\right) + \sum_{i \in [n]} a_i \\ & ~ ~ ~ ~ - \sum_{i \in [n]} \alpha_i y_i \left( \sum_{i \in [n]}\alpha_i y_i x_i^T \right) ^T x_i - b \sum_{i \in [n]} \alpha_i y_i\\ &= \max_{\alpha \ge 0} \sum_{i \in [n]} \alpha_i - \frac{1}{2} \sum_{i \in [n]}\sum_{j \in [n]} \alpha_i \alpha_j y_i y_j x_i^T x_j \end{aligned}

subject to {αi≥0,∀i∈[n]∑aiyi=0,∀i∈[n]\displaystyle \begin{cases} \alpha_i\ge 0, & \forall i\in [n] \\ \sum a_i y_i = 0, & \forall i \in [n] \end{cases},优化问题变为优化 nn 个 αi\alpha_i,原来的原始形式则是优化 d+1d+1 个变量。

假设将 α∗\alpha^* 解出来了,考虑解 w∗,b∗w^*,b^*:

首先显然

w∗=∑i∈[n]αiyixiw^* = \sum_{i\in [n]}\alpha_i y_i x_i

然后,对于支持向量 (xk,yk)(x_k,y_k),有 yk(w∗Txk+b∗)=1y_k(w^{*T}x_k + b^*)=1,所以 b∗=yk−w∗Txkb^* = y_k - w^{*T}x_k,这也告诉我们 1yk=yk\displaystyle \frac{1}{y_k} = y_k。

然后对于 active 的约束,αi∗>0\alpha_i^*>0。

其实,只需要支持向量就够了。

w∗=∑(xi,yi) is a S.V.αi∗yixiw^* = \sum_{(x_i,y_i)\text{ is a S.V.}}\alpha_i^*y_i x_i

SMO 算法(sequential minimum optimization)

刚才我们是假设求解出来了对偶问题,现在考虑如何求解。

  1. 主要思路:迭代地更新 αi\alpha_i,而固定其他的 αj\alpha_j。

  2. 但是 ∑αiyi=0\sum \alpha_i y_i = 0,所以若固定了其他的 n−1n-1 个 αj\alpha_j,αi\alpha_i 就已经可以被确定了,所以不能简单地这样去做。

    改进:每次挑两个 αi\alpha_i 和 αj\alpha_j,而固定其他的 n−2n-2 个。注意到 αiyi+αjyj=−∑k≠i,jαkyk=Constant\displaystyle \alpha_i y_i + \alpha_j y_j= -\sum_{k \ne i,j} \alpha_k y_k = \text{Constant}。于是可以用 αi\alpha_i 表示 αj\alpha_j。

  3. 解这个一维的二次规划(另外 n−2n-2 个被固定了,选的一个可以表示另一个),这自然是好解的,甚至有闭式解。

  4. 重复上述步骤,每次取 αi,αj\alpha_i,\alpha_j,迭代到你想结束为止。

核技巧(Kernel Trick)

考虑对 xix_i 做变换 φ(xi)\varphi(x_i)(可以是变换到高维空间)

然后便可以将 φ(xi)Tφ(xj)T\varphi(x_i)^T \varphi(x_j)^T 表示为 k(xi,xj)k(x_i,x_j),这表示了 xix_i 与 xjx_j 的相似度。其实,原来的 xiTxjx_i^T x_j 也算一种核(线性核)

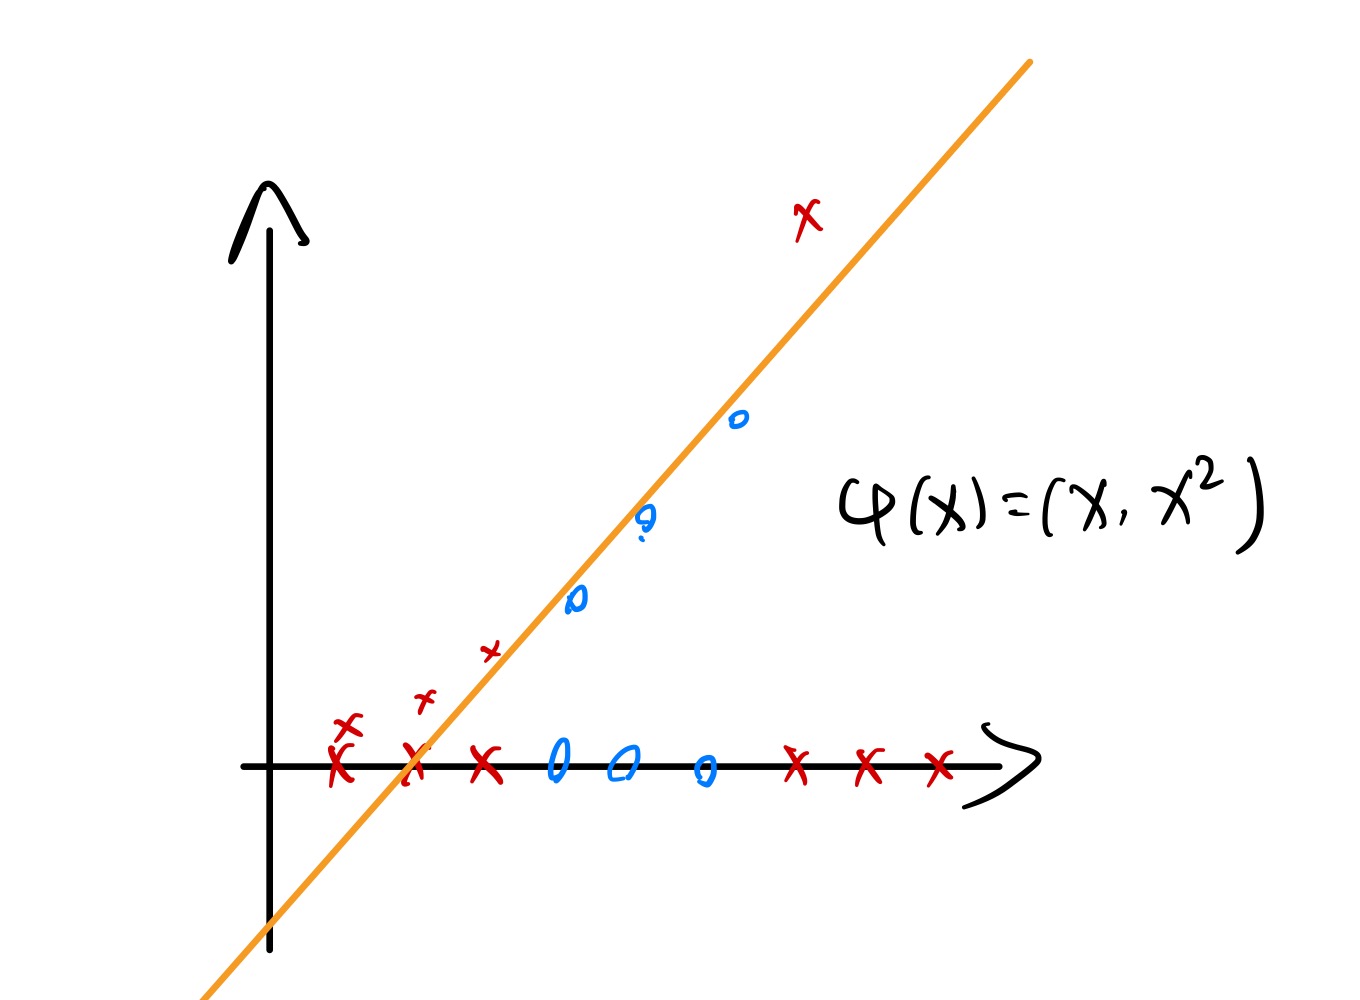
假设 xx 为一维,但线性不可分。而用一个核函数 φ(x)=(x,x2)\varphi(x) = (x,x^{2}),其就可以线性可分了:

svm_kernel

所以这就为我们提供了方便:把本来非线性可分原始数据用核函数进行升维,变为线性可分后用 SVM 求解,求解到的超平面还可以映射回原空间(当然就变得非线性了)

现在,考虑 x=(x1,x2)T∈R2x = (x_1,x_2)^T \in \mathbb{R}^2,定义 φ(x)=(1,x1,x2,x12,x22,x1x2)∈R6\varphi(x) = (1, x_1, x_2, x_1^{2},x_2^{2},x_1x_2) \in \mathbb{R}^6,计算的时候有两种方法:

  1. 可以直接算所有的 φ(xi)Tφ(xj)∈R6\varphi(x_i)^T \varphi(x_j) \in \mathbb{R}^6,相当于先映射到高维空间后做计算,但这样计算的复杂度也会相应高;
  2. 在低维空间用 k(xi,xj)k(x_i,x_j) 直接把他们的相似度算出来(kernel trick),就不需要先把他们映射到高维空间了。

E. g. 考虑 x=(x1,x2)T,z=(z1,z2)Tx = (x_1,x_2)^T,z=(z_1,z_2)^T,定义核函数 k(x,z)=(xTz+1)2k(x,z) = (x^Tz+1)^2。展开:

k(x,z)=(xTz+1)2=(x1z1+x2z2+1)2=x12z12+x22z22+1+2x1z1+2x2z2+2x1z1x2z2=(1,2x1,2x2,x12,x22,2x1x2)T⋅(1,2z1,2z2,z12,z22,2z1z2)\begin{aligned} k(x,z) &= (x^Tz+1)^{2}\\ &= (x_1 z_1 + x_2 z_2 + 1)^2 \\ &= x_1^{2}z_1^{2}+x_2^{2}z_2^{2}+1+2x_1z_1+2x_2z_2+2x_1z_1x_2z_2\\ &= (1, \sqrt{2}x_1,\sqrt{2}x_2,x_1^{2},x_2^{2},\sqrt{2}x_1x_2)^T \cdot (1,\sqrt{2} z_1, \sqrt{2} z_2, z_1^{2},z_2^{2},\sqrt{2} z_1z_2) \end{aligned}

那其实便可看出来 φ(x)=(1,2x1,2x2,x12,x22,2x1x2)T\varphi(x) = (1, \sqrt{2}x_1,\sqrt{2}x_2,x_1^{2},x_2^{2},\sqrt{2}x_1x_2)^T,若用了 kernel trick 显然就能达到更低的时间复杂度。

核函数合法性的判断:k(⋅,⋅)k(\cdot ,\cdot ) 合法仅当 ∃φ\exists \varphi 使得 k(x,z)=φ(x)Tφ(z)Tk(x,z) = \varphi(x)^T \varphi(z)^T。显然一个输出负数的核函数绝对是不合法的。接下来介绍 Mercer Theorem:k(⋅,⋅)k(\cdot ,\cdot ) 合法当且仅当:

  1. 对称性:k(x,z)=k(z,x),∀x,zk(x,z) = k(z,x), \forall x,z
  2. 核矩阵(kernel matrix, gram matrix)半正定

    K:=[k(x1,x1)k(x1,x2)⋯k(x1,xn)⋮⋮⋮k(xn,x1)k(xn,x2)⋯k(xn,xn)]∈Rn×nK := \begin{bmatrix} k(x_1,x_1) & k(x_1,x_2) & \cdots & k(x_1,x_n) \\ \vdots & \vdots & & \vdots \\ k(x_n,x_1) & k(x_n,x_2) & \cdots & k(x_n,x_n) \\\end{bmatrix}\in \mathbb{R}^{n\times n}

这里不打算证明,给出一个 intuition:KK 对称且半正定所以肯定可以对角化,且所有特征值 ≥0\ge 0。则 K=∑kλkμkμkTK= \sum_k \lambda_k \mu_k \mu_k^T,Kij=∑kλkμkjμkiK_{ij} = \sum_k \lambda_k \mu_{kj} \mu_{ki},所以这样其实已经将 φ\varphi 给出。(不考)

常见的核函数:

  • 线性核:k(x,z)=xTzk(x,z) = x^T z;
  • 多项式核:k(x,z)=(xTz+1)pk(x,z) = (x^Tz + 1)^p,Rd→RO(min⁡(pd,dp))\mathbb{R}^d \to \mathbb{R}^{O(\min(p^d,d^p))};
  • 高斯核(RBF Kernel,radial basis function):

    k(x,z)=exp⁡(−∥x−z∥22σ2)k(x,z) = \exp\left( - \frac{\left\| x-z \right\|^{2}}{2\sigma^2} \right)

高斯核相当于把 xx 映射到无穷维空间然后做内积?考虑泰勒展开:

f(x)=f(0)+f′(0)x+f′′(0)2!x2+⋯f(x) = f(0)+f'(0)x+\frac{f''(0)}{2!}x^{2}+ \cdots

将 k(x,z)k(x,z) 写出来:

k(x,z)=exp⁡(−∥x∥22σ2)exp⁡(−∥z∥22σ2)exp⁡(1σ2xTz)\begin{aligned} k(x,z)&= \exp\left( -\frac{\left\| x \right\|^2}{2\sigma^{2}} \right) \exp\left( -\frac{\left\| z \right\|^2}{2\sigma^{2}} \right) \exp\left(\frac{1}{\sigma^{2}}x^Tz\right) \\ \end{aligned}

将最后一项进行泰勒展开:

exp⁡(1σ2xTz)=1+1σ2xTz+12!(xTz)2(σ2)2+13!(xTz)3(σ2)3+⋯\begin{aligned} &\exp\left(\frac{1}{\sigma^{2}}x^Tz\right) \\ =& 1+ \frac{1}{\sigma^{2}} x^Tz + \frac{1}{2!} \frac{(x^Tz)^{2}}{(\sigma^{2})^{2}} + \frac{1}{3!}\frac{(x^Tz)^3}{(\sigma^{2})^3}+ \cdots \end{aligned}

后面是一堆多项式核的叠加!根据前面的定理,合法的核函数相加后仍然合法。

事实上,σ\sigma 是很重要的超参数。更大的 σ2\sigma^{2} 会使得高阶项迅速趋于 00,有效的维度就会降低;小的 σ2\sigma^{2} 有可能让任意的数据均可分,带来过拟合的风险,对 outlier 不健壮。

松弛变量(slack variables)

现在问题的关键在于如何处理离群点(outliers)。

之前,我们都是硬约束,即要求 ∀i,yi(wTxi+b)≥1\forall i, y_i(w^Tx_i+b)\ge 1。现在考虑软约束,引入松弛变量(slack variables)ξi\xi_i。

现在约束变成 ∀i∈[n],yi(wTxi+b)≥1−ξi\forall i \in [n], y_i(w^T x_i +b)\ge 1-\xi_i,其中 ξi≥0\xi_i\ge 0(允许超过 wTx+b=±1w^Tx+b=\pm 1 一定距离 ξi\xi_i)

但同时,肯定不能让 ξi\xi_i 任意优化。我们肯定希望 ξi\xi_i 尽可能小。优化问题变成:

min⁡w,b,ξ12∥w∥2+C⋅∑i∈[n]ξi\min_{w,b,\xi} \frac{1}{2} \left\| w \right\|^{2} + C \cdot \sum_{i \in [n]} \xi_i

s. t. yi(wTxi)≥1−ξi,ξi≥0,∀i∈[n]y_i(w^Tx_i) \ge 1 - \xi_i, \xi_i\ge 0,\forall i \in [n]。其中 CC 为调控 ξ\xi 力度的参数。事实上这才是 SVM 实战中最常用的形式。

注意到 ξi≥max⁡(0,1−yi(wTxi+b))\xi_i\ge \max(0, 1-y_i(w^T x_i+b)),所以问题可以进一步化简:

min⁡w,b12∥w∥2+C⋅∑i∈[n]max⁡(0,1−yi(wTxi+b))\min_{w,b} \frac{1}{2} \left\| w \right\|^{2}+C\cdot \sum_{i \in [n]}\max(0, 1-y_i(w^T x_i+b))

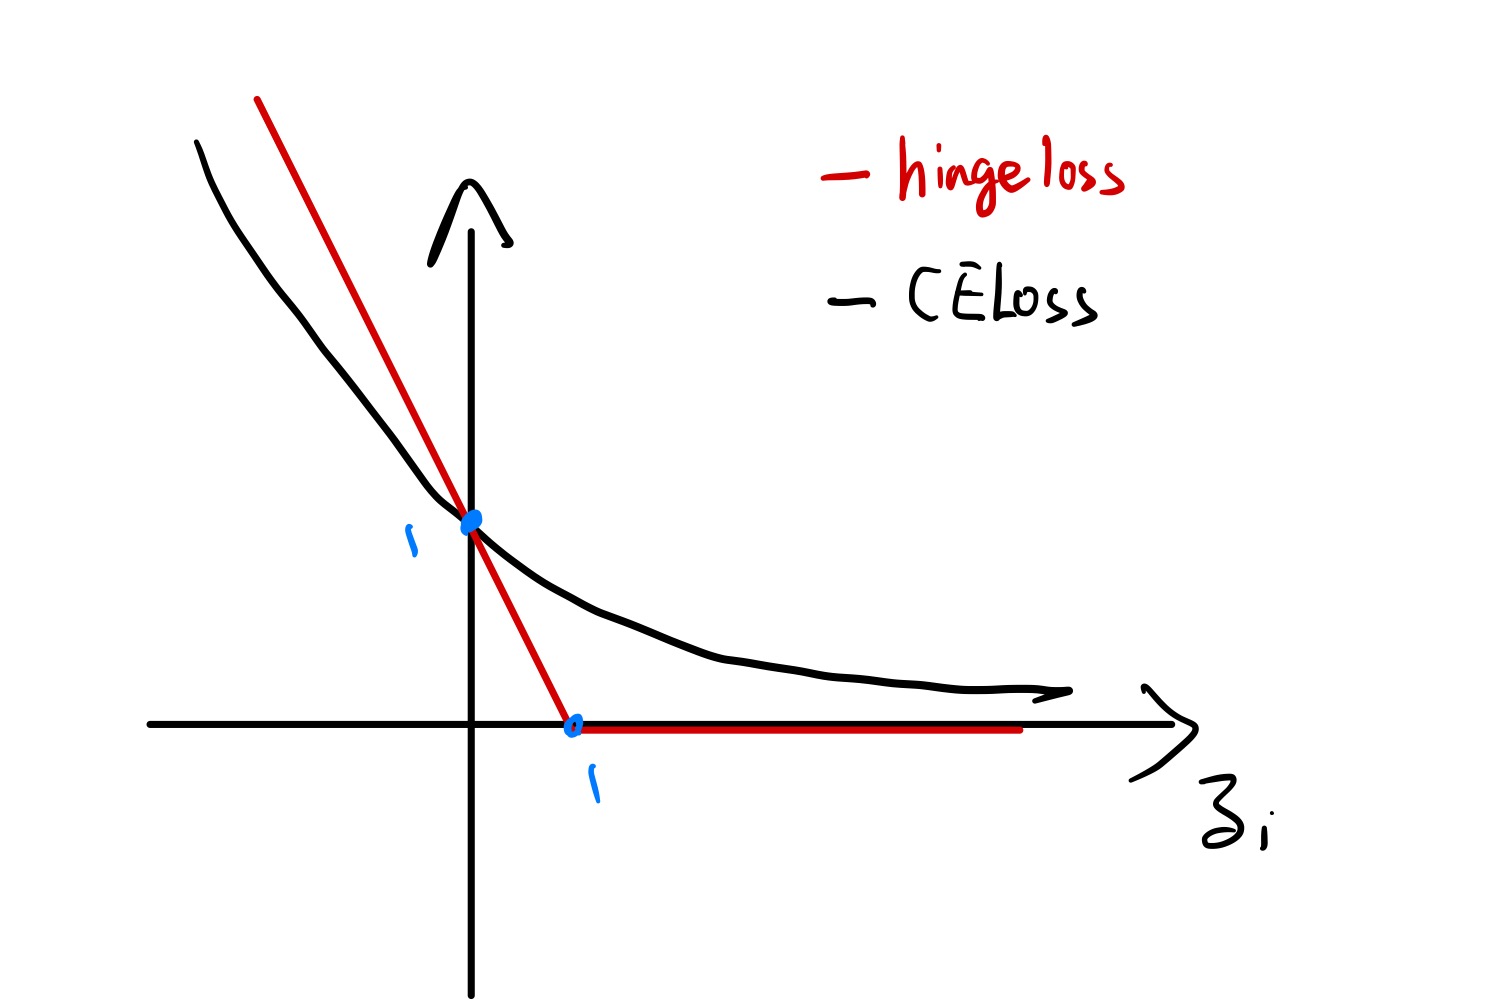
这里是直接用 ξ\xi 的下界去进行替换。而且注意到 max⁡(0,1−yi(wTxi+b))\max(0, 1-y_i(w^Tx_i+b)) 其实为合页损失(hinge loss)。定义 zi:=yif(xi)z_i:= y_i f(x_i)

svm_slack_var

zi>1z_i>1 的情况相当于点不产生贡献,zi<1z_i <1 的情况就对应着 ξi>0\xi_i>0 的情况,产生正比于 ξi\xi_i 的 loss。而这个时候 ∥w∥2\left\| w \right\|^2 就可以理解为正则化项了(倒反天罡)。


24秋机器学习笔记-04-支持向量机(SVM)
https://blog.imyangty.com/note-ml2024fall/svm/
Author
YangTY
Posted on
October 9, 2024
Licensed under